Aidit 修業規劃 Agent
會查證、會說「不知道」的畢業審查與選課 Agent · 2026
核心概念
在畢業審查場域,答錯的代價遠高於不答。
畢業審查、選課建議、情境試算與修業問答的 Agent。學分由確定性引擎計算,模型只負責理解使用者意圖;規定沒寫清楚的地方不硬算,改列為待確認事項並告訴你該問哪個單位。每個結論都能回查到規定原文。
直接把成績單丟給 LLM 算學分,看起來很聰明,但同一題問兩次常常得到不同答案,也說不出依據是哪一條規定。Aidit 把「理解」和「計算」拆開:模型只負責聽懂你想問什麼,數字全由可驗證的程式算出,並且每一個結論都能回查到規定原文。
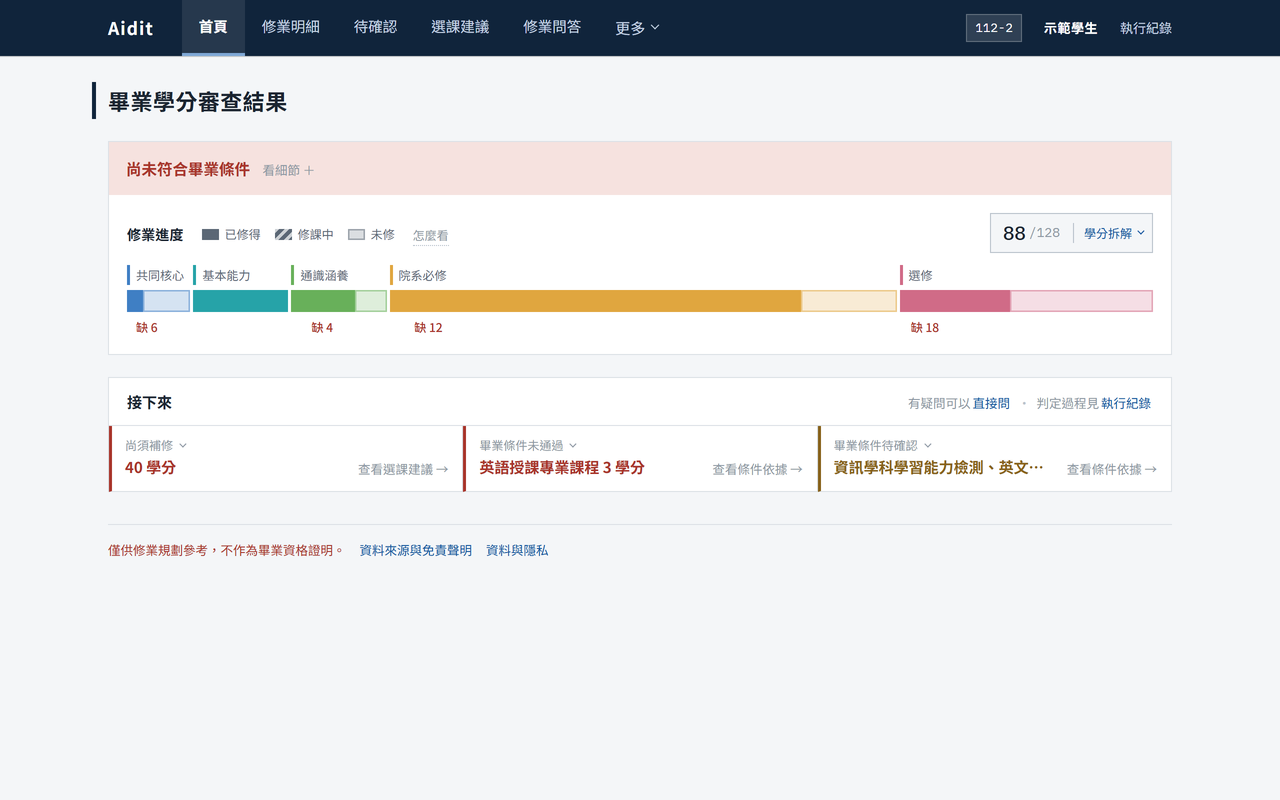
功能
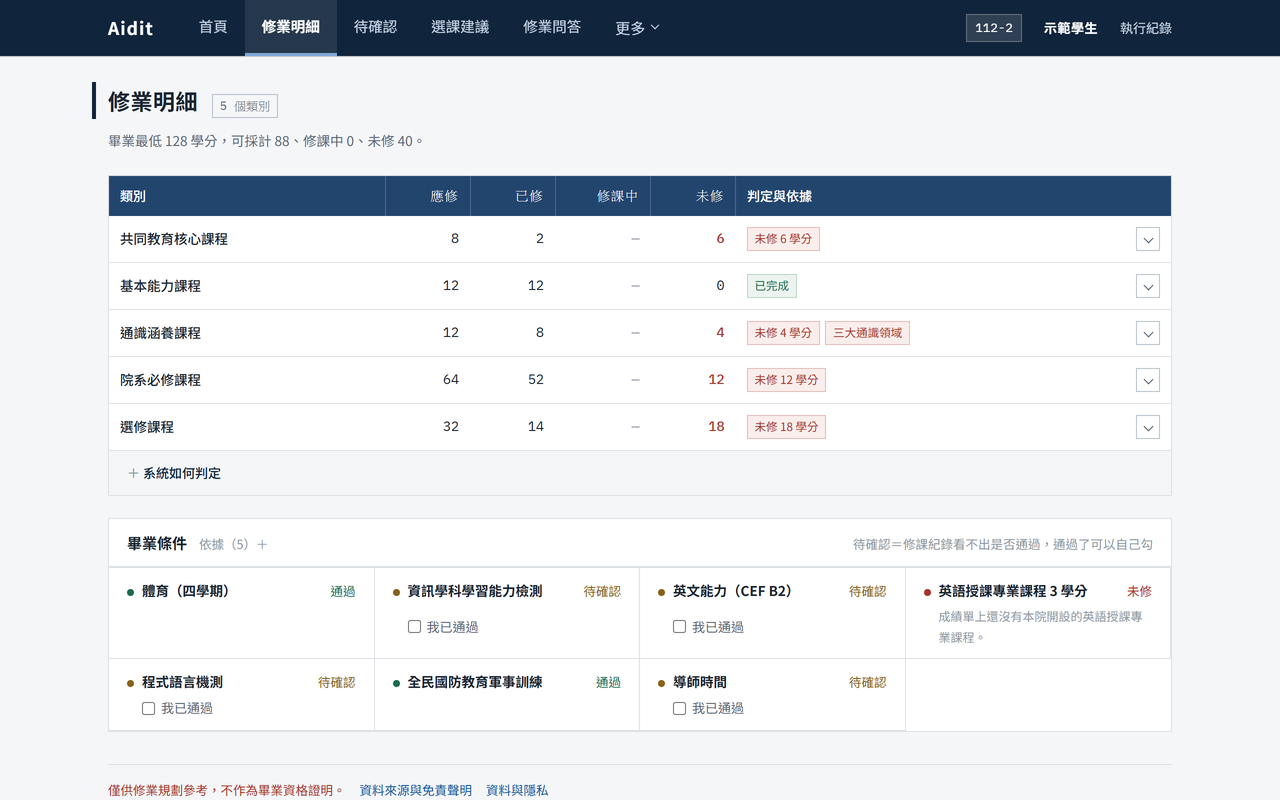
修業明細
逐類別比對已修與應修學分,每一列都能展開,看採計了哪些課、引用的是哪一條規定原文。
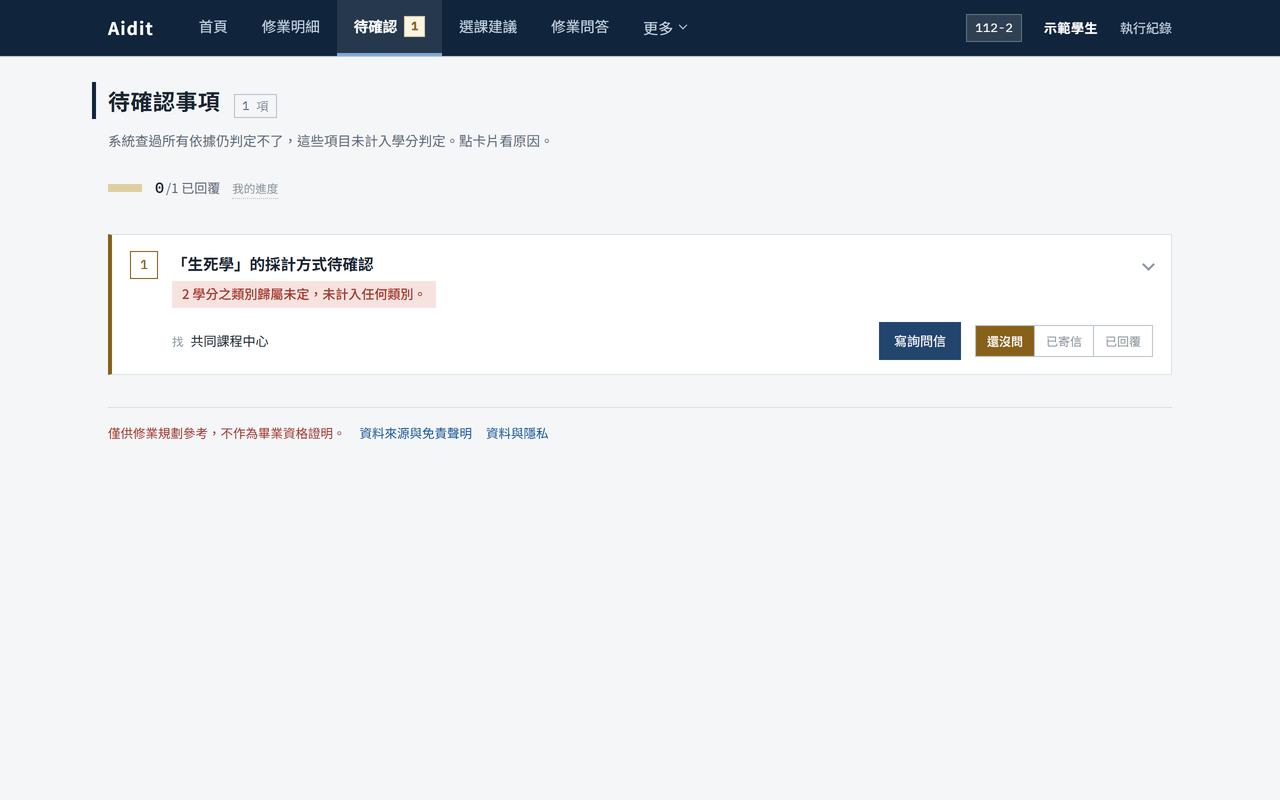
待確認事項
規定沒寫清楚就停下來,不替你猜。說明這件事會影響幾學分、該找哪個單位確認,並可一鍵產生詢問信。
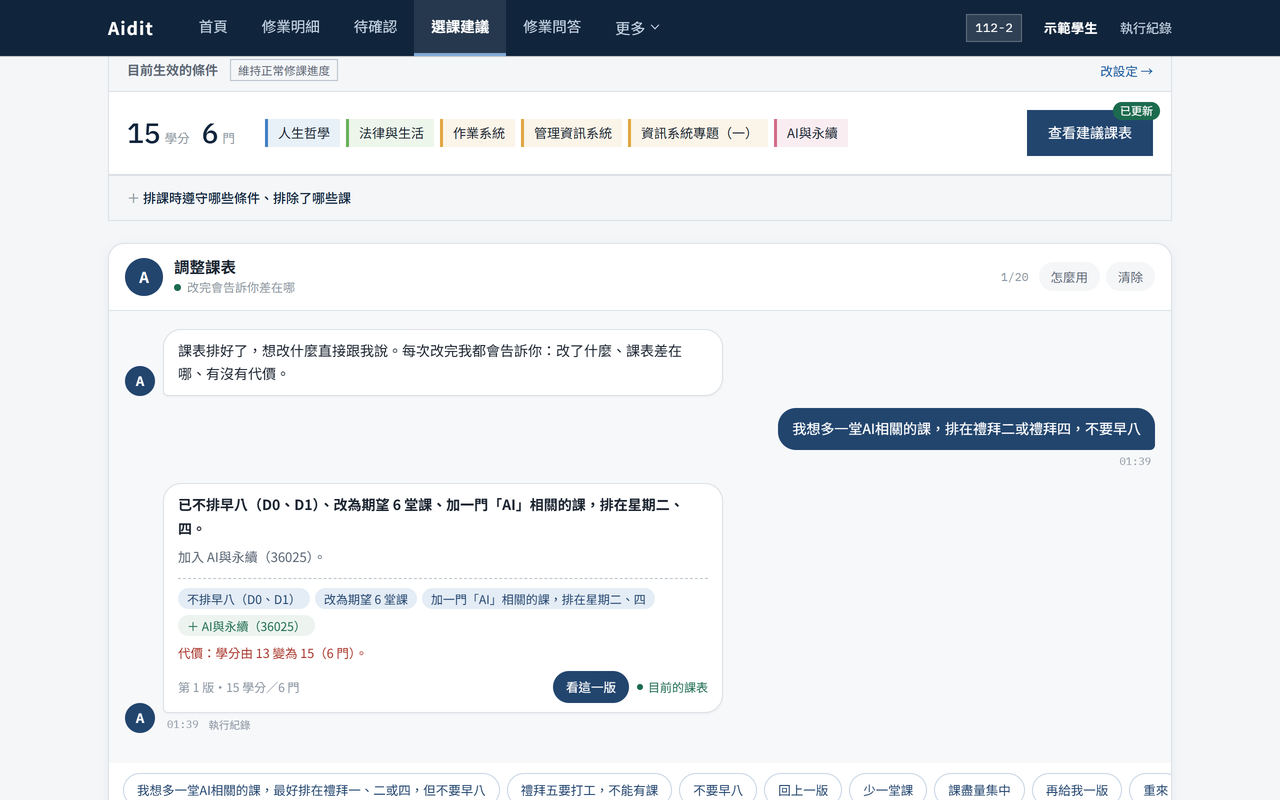
選課建議
依未修學分與學校公開的開課資料排出下學期課表;可以用一句話微調,系統會回報改了什麼、代價是什麼。
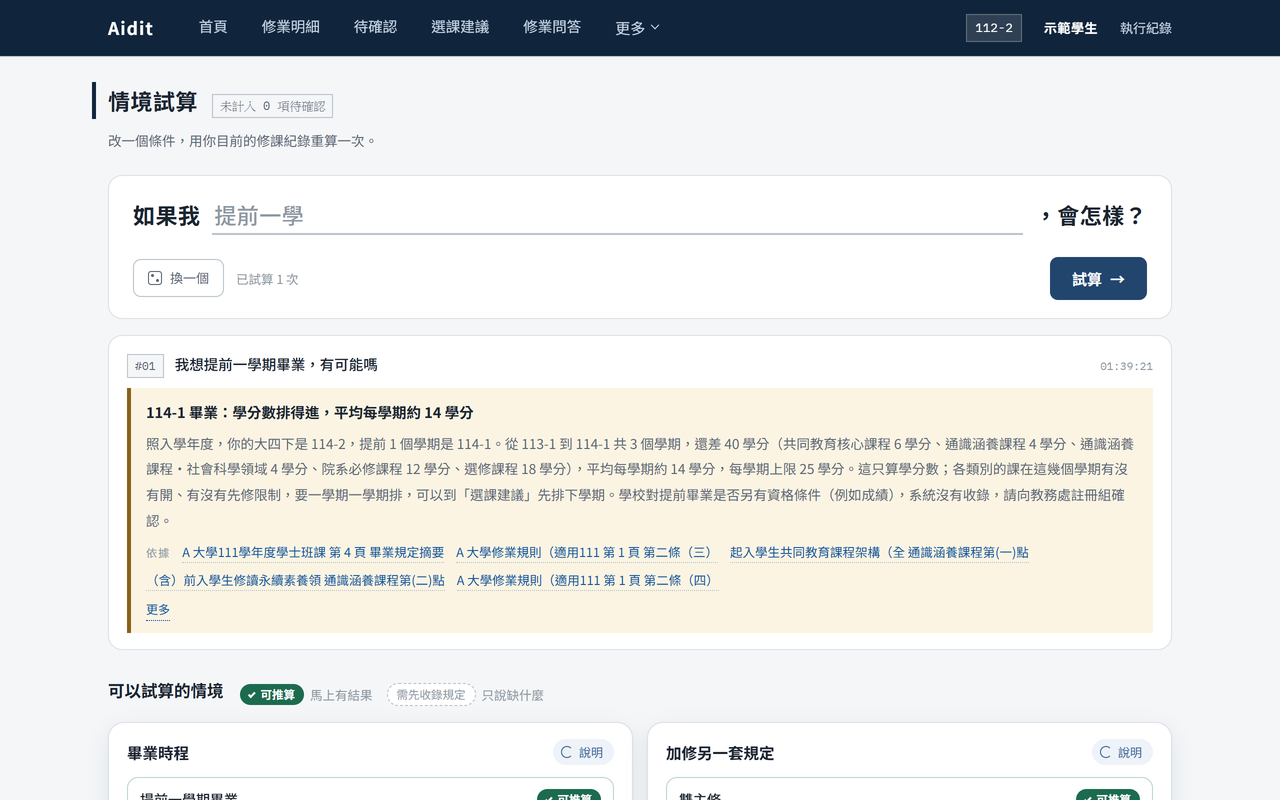
情境試算
提前畢業、停修、雙主修、輔系、學程,依規定逐項推算;沒有收錄的規定會明講,不推算。
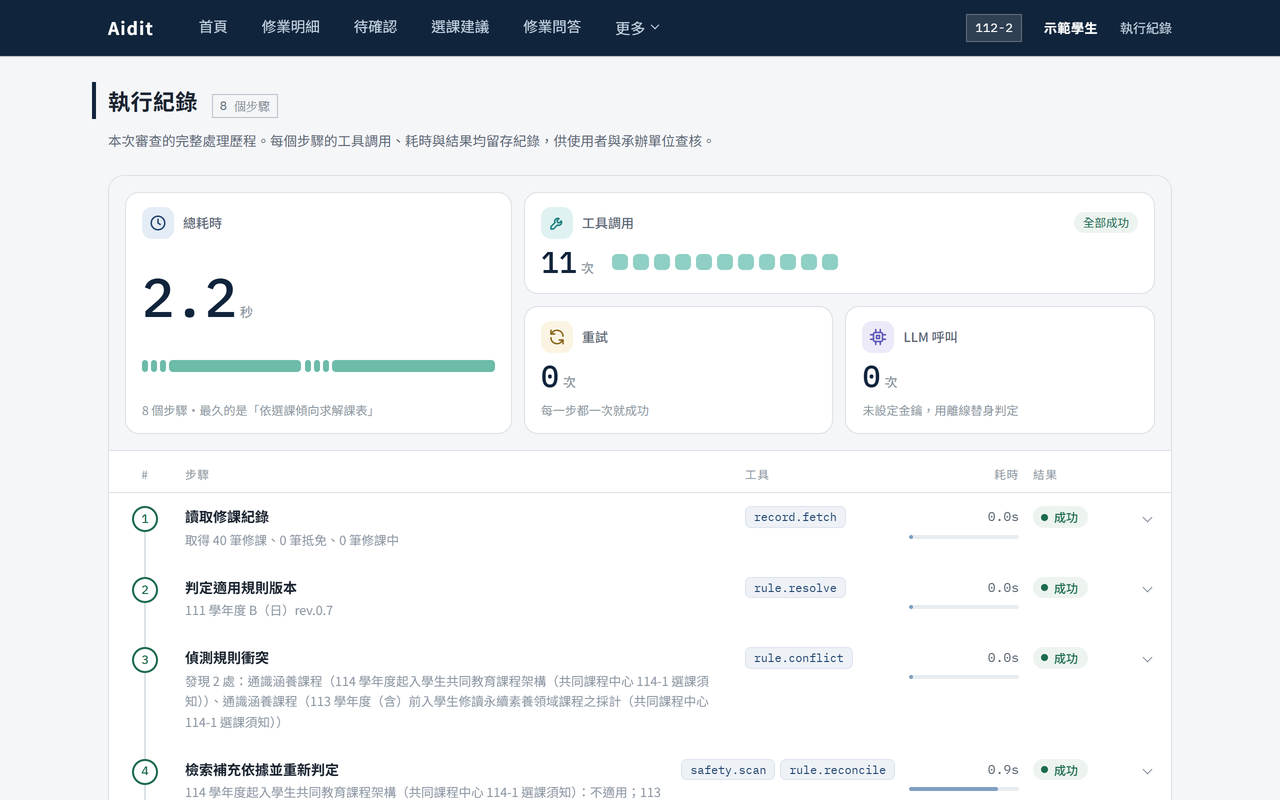
執行紀錄
每一步用了哪個工具、耗時多久、有沒有重試或走到分支,全部留下紀錄,可匯出查核。
怎麼保證不亂算
算數的那層沒有模型
學分審查、排課求解、原文回查都是純確定性運算。CI 會對這三個模組做遞移相依分析,任何一層 import 到 LLM client 就直接失敗。
不變式失敗就中止
各類學分加總對不上就不輸出結果;超修的學分不能拿去填補其他類別。寧可不答,也不給錯的答案。
結論都能回查原文
規則包的每個欄位都附原文引句,輸出前逐條比對;對不上就重試一次,仍失敗則把該條降級為待確認。
回覆的字不是模型寫的
模型只輸出意圖與參數,schema 結構上就沒有「回答」欄位;回覆由模板組成,學分數字一律等於引擎算出來的數字。
規則的洞寫在資料裡
規則包用 ambiguities 記錄規定沒寫清楚的地方,命中的修課會移出判定、產生待確認事項。
外部內容是資料,不是指令
公告與使用者訊息都先過提示注入檢查,命中就不送進模型。
Agent 流程
沒有引入 agent 框架:流程有限且已知,一個 step runner 加狀態機就夠,trace 格式也要自己掌控。
讀取修課紀錄
讀取失敗就直接回報錯誤,不輸出任何部分結果。
比對規則版本
依入學學年找出適用的規則包;學籍與入學學年對不上時,整案轉人工處理。
公告衝突處理
偵測新公告與規則包是否衝突。判斷公告是否適用時,先過注入檢查,再交給模型;無法判定的列為待確認,該項不計入。
確定性審查
把每門課指派到學分類別(指派問題),計算各類學分;不變式失敗即中止。
原文引用回查
逐條比對結論與規定原文,失敗兩次的條目降級為待確認。
開課搜尋與排課
從開課資料中以分支定界求解選課組合;無解時找出衝突條件、放寬後重試。